 PAFworks
Configurer l’assistant pour votre organisation
Vous décidez quels modèles de langage l’assistant peut utiliser, ce qu’ils coûtent, jusqu’où peut aller une conversation, et ce à quoi l’assistant peut accéder en plus de vos fichiers et de votre messagerie : le web, les programmes, la recherche par le sens et les applications de votre organisation.
Ce qu’il vous faut
- Un compte administrateur dans PAFworks : les réglages ci-dessous se trouvent dans Admin, que les autres comptes ne voient pas.
- Un compte auprès d’au moins un fournisseur de modèles — un abonnement Infomaniak AI Tools, une clé d’API Anthropic ou OpenAI — ou votre propre serveur Ollama.
- Pour les connecteurs d’API : l’adresse de votre application et une clé ou un compte avec lequel elle permet de se connecter.
Où sont les réglages
Cliquez sur Admin en bas de la barre de gauche. Le groupe IA de l’administration réunit trois pages :
| Page | Ce qu’elle contient |
|---|---|
| Modèles de langage | Les interrupteurs, les modèles et leurs prix, le modèle utilisé pour le rangement automatique, la clé partagée, la recherche par le sens et la reconnaissance de texte. |
| Assistant | Les interrupteurs de l’assistant, ses limites par compte, le bac à sable des programmes et la recherche web. |
| Connecteurs d'API | Les applications extérieures que l’assistant peut appeler, et qui peut les utiliser. |
Étape 1 — Activer l’assistant
En haut de Modèles de langage, cochez Activer les modèles de langage — l’interrupteur général de tous les modèles, pour le rangement automatique comme pour l’assistant — et Activer l'assistant, puis cliquez sur Enregistrer. Tant que l’un des deux est désactivé, l’assistant est absent pour tout le monde : ni page, ni entrée dans la barre de gauche.
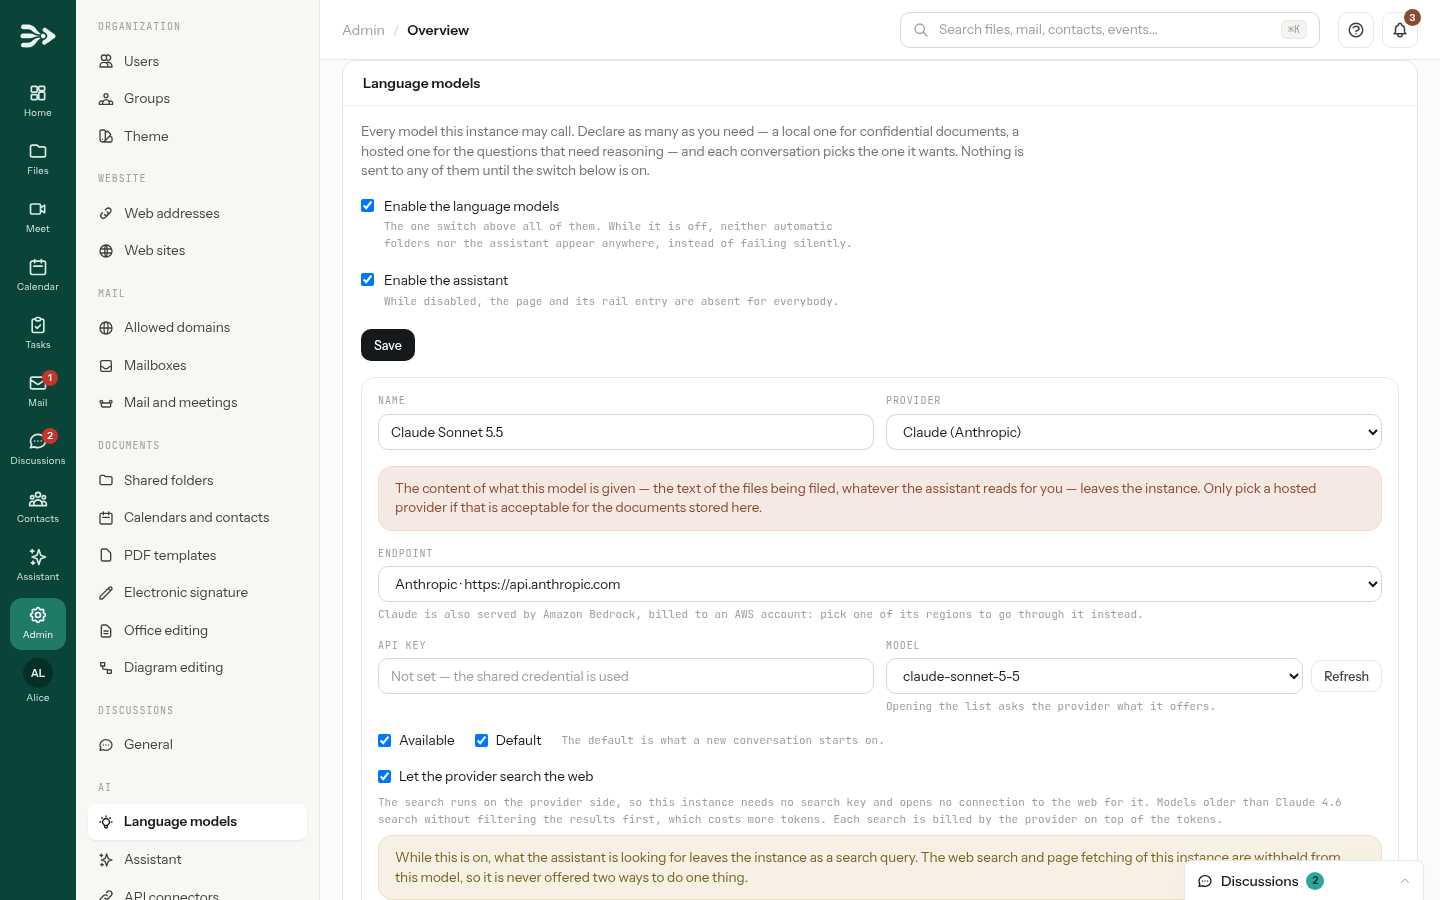
L’assistant n’apparaît aussi qu’une fois déclaré un modèle capable d’utiliser ses outils : la page Assistant le signale s’il en manque un. Si PAFworks fournit un modèle pour votre espace, la page indique lequel ; un modèle que vous ajoutez prend le relais.
Étape 2 — Déclarer les modèles de langage
-
Sous les interrupteurs, cliquez sur Ajouter un modèle. Une carte vierge apparaît.
-
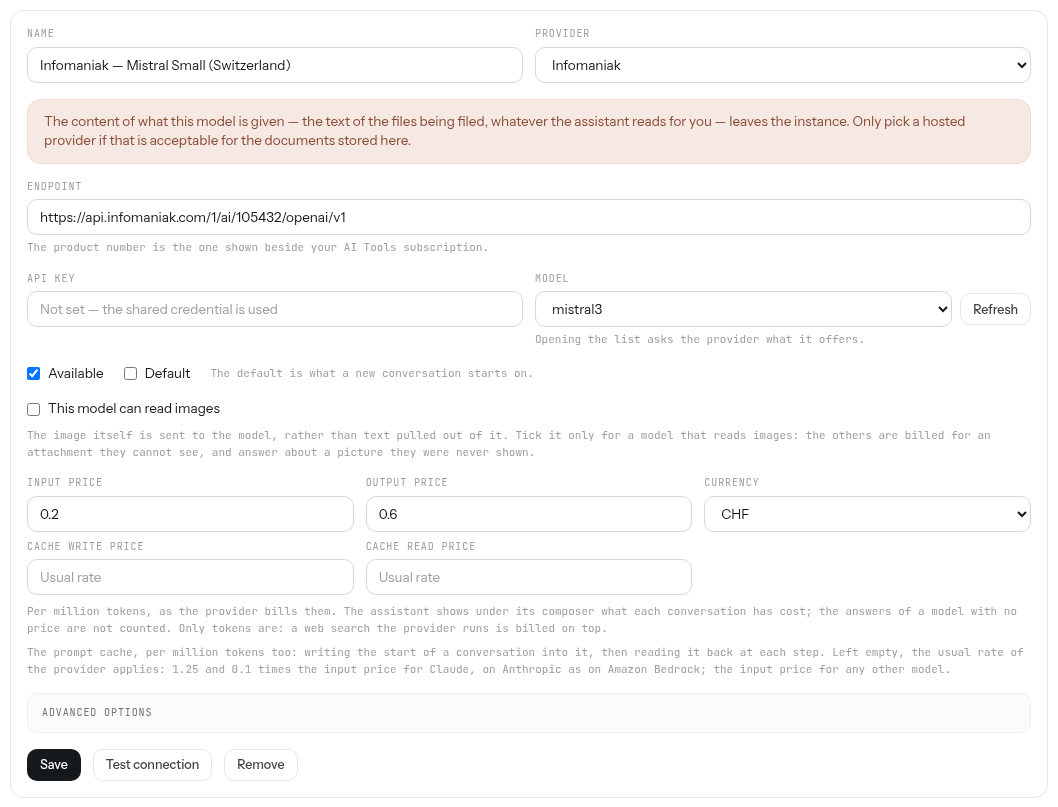
Donnez-lui un Nom que chacun reconnaîtra dans le menu des modèles — indiquez où il tourne, par exemple « Infomaniak — Mistral Small (Suisse) » — et choisissez son Fournisseur.
Fournisseur Ce que demande la carte Infomaniak Le Point d'accès de votre produit AI Tools, avec le numéro de produit affiché à côté de votre abonnement, et une clé. Claude (Anthropic) Une clé d’API Anthropic. Le Point d'accès est par défaut celui d’Anthropic. OpenAI Une clé d’API OpenAI. Ollama (local) L’Adresse du serveur de votre serveur Ollama. Une clé seulement si votre serveur en demande une. Personnalisé (compatible OpenAI) Le Point d'accès d’un serveur qui parle l’API OpenAI, l’identifiant du modèle saisi à la main, et une clé si le serveur en demande une. -
Collez la Clé d'API, ou laissez-la vide pour utiliser la clé partagée (voir plus bas). Ouvrez ensuite Modèle : la liste est demandée au fournisseur dès qu’il y a une clé ; Actualiser la redemande.
-
Laissez Disponible coché pour proposer le modèle ; cochez Par défaut pour le modèle sur lequel démarrent les nouvelles conversations. Ne cochez Ce modèle sait lire les images que pour un modèle qui en est capable : les images lui sont alors envoyées sous forme d’images.
-
Saisissez les prix, si vous voulez que le coût des conversations soit affiché (voir Prix et coût), puis cliquez sur Enregistrer.
Un encadré rouge sur la carte rappelle que le contenu confié à un modèle hébergé — le texte des fichiers à ranger, tout ce que l’assistant lit pour quelqu’un — quitte votre PAFworks. Un modèle exécuté sur votre propre serveur Ollama le garde chez vous. Déclarez autant de modèles que nécessaire : par exemple un modèle local pour les documents confidentiels et un modèle hébergé pour les questions qui demandent du raisonnement.
Une clé pour plusieurs modèles
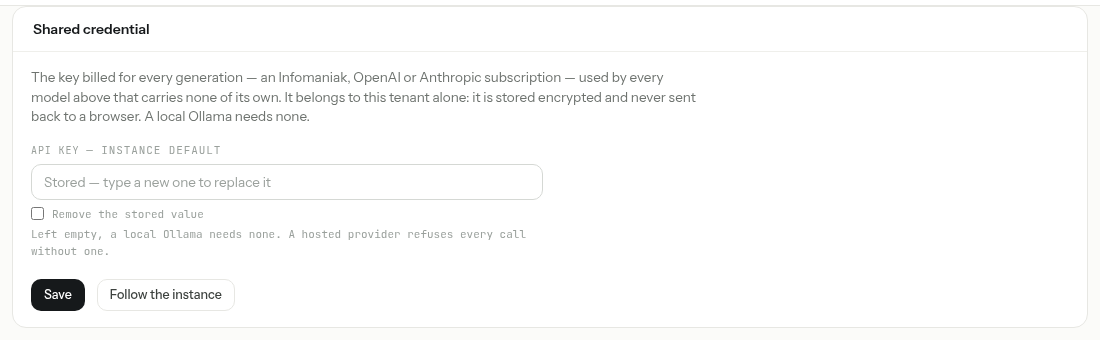
Plusieurs modèles d’un même fournisseur peuvent partager une clé : saisissez-la une seule fois dans Identifiant partagé, plus bas sur la page. Un modèle qui a sa propre clé utilise la sienne. La clé est stockée chiffrée et n’est plus jamais affichée ; Supprimer la valeur enregistrée l’efface.
Options avancées, sur chaque carte, réunit des valeurs de réglage dont les valeurs par défaut fonctionnent : la taille de contexte d’un modèle Ollama, les budgets de réponse, le délai d’attente, les nouvelles tentatives et l’ordre des modèles dans le menu. Le panneau Dossiers automatiques choisit le modèle utilisé pour ranger les documents : voir Classer vos documents automatiquement.
Étape 3 — Le tester
- Tester la connexion, sur la carte d’un modèle, vérifie que le fournisseur répond, avec les valeurs saisies sur la carte, enregistrées ou non, et affiche le résultat à côté des boutons.
- Tester, sur la page Assistant, vérifie que le modèle par défaut utilise réellement les outils de l’assistant — un point d’accès peut répondre par des mots et les ignorer — et que les programmes peuvent s’exécuter : Le point d'accès utilise les outils : l'assistant peut agir sur votre compte.
Un modèle lent peut échouer au test et fonctionner quand même. Tester la connexion abandonne au bout de 15 secondes par défaut. Un modèle plus long à commencer sa réponse apparaît ici comme injoignable, alors que les conversations, qui attendent jusqu’à deux minutes par défaut (le Délai d'attente (secondes) de la carte), fonctionnent. Un modèle qui réfléchit avant de répondre réussit le test même s’il n’a rien écrit dans les quelques mots que le test autorise.
Qui utilise quel modèle
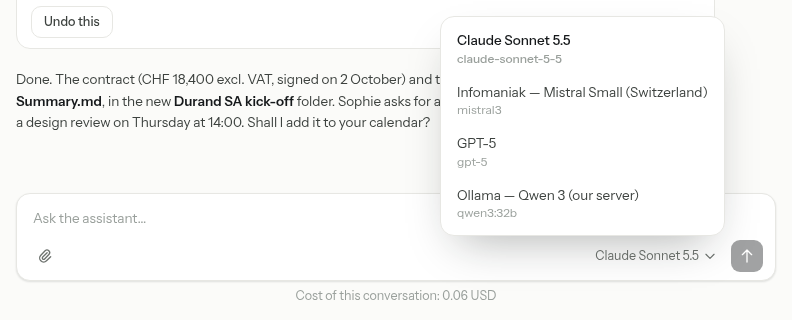
Chaque modèle marqué Disponible et capable d’utiliser les outils de l’assistant est proposé à tous les comptes : il n’y a pas de choix par personne ni par groupe. À partir de deux modèles, chacun en choisit un par conversation dans le menu à côté de sa zone de saisie ; avec un seul, il n’y a pas de menu. Une nouvelle conversation démarre sur le modèle Par défaut.
Retirer un modèle demande d’abord confirmation : les conversations qui l’utilisaient repassent sur le modèle par défaut.
Les prix et le coût d’une conversation
Sur chaque carte, Prix en entrée et Prix en sortie s’entendent par million de tokens, comme le fournisseur les facture, dans la Devise que vous choisissez (CHF, EUR, USD ou GBP). Prix d'écriture en cache et Prix de lecture en cache peuvent rester vides : le tarif habituel du fournisseur s’applique alors.
- Sous la zone de chaque conversation, chacun voit Coût de cette conversation, avec un montant par devise. Chaque réponse compte au prix qu’avait le modèle quand elle a été écrite : changer un prix par la suite ne change pas les coûts passés.
- Les réponses d’un modèle sans prix ne sont pas comptées, et la ligne indique (incomplet). Une recherche web effectuée par le fournisseur est facturée par celui-ci en plus des tokens et n’entre pas dans le chiffre.
- Il n’y a pas de plafond de dépense : ce sont les limites ci-dessous qui bornent une conversation.
Les limites de l’assistant
Sur la page Assistant, les nombres bornent ce qu’une conversation qui s’emballe peut coûter en temps et en tokens. Ils s’appliquent à chaque compte ; cliquez sur Enregistrer après une modification.
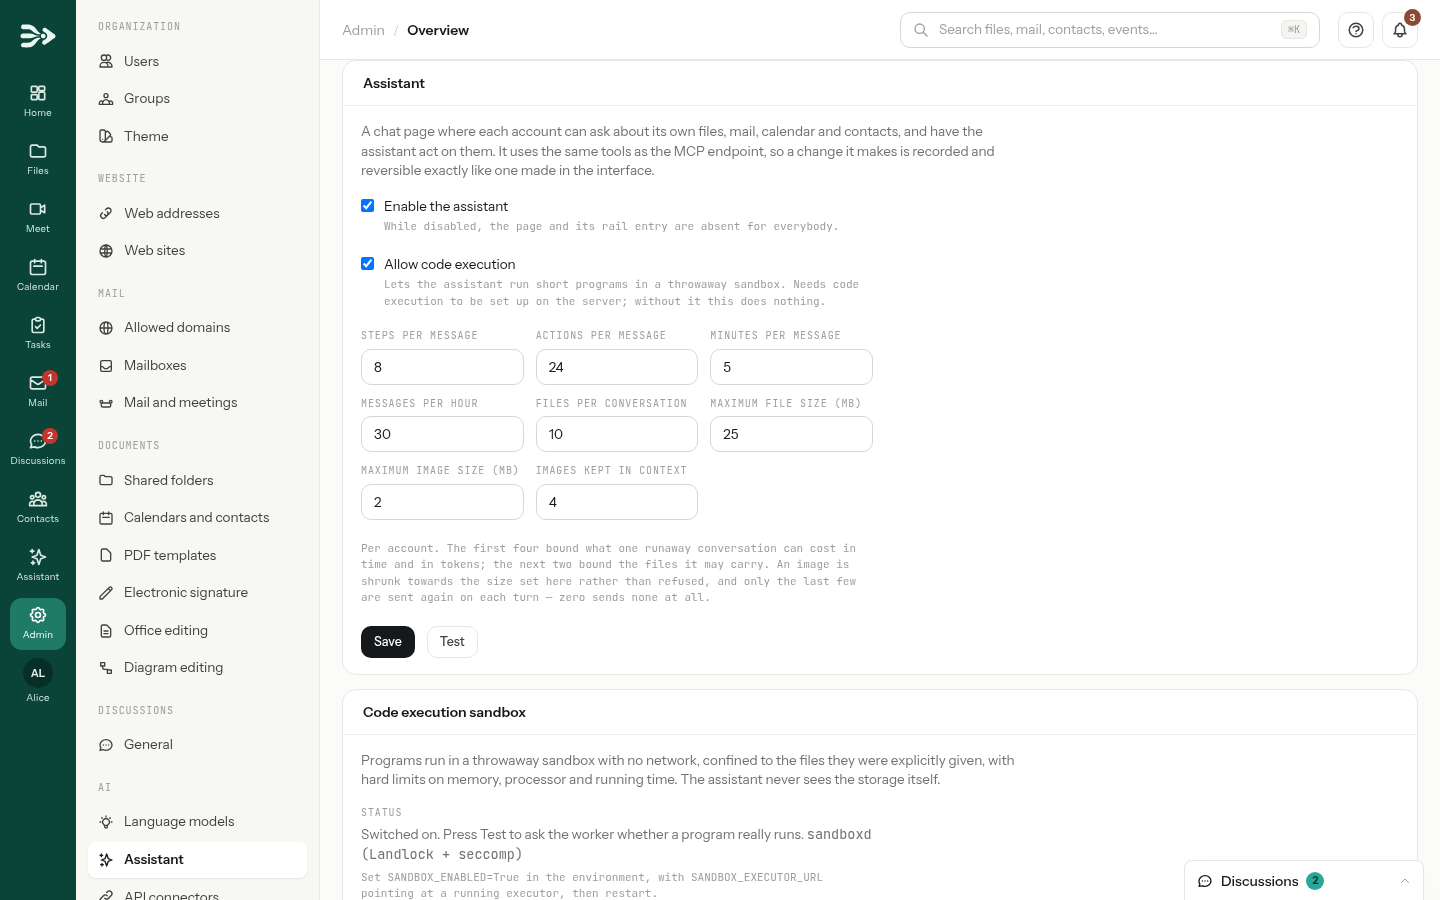
| Réglage | Par défaut | Ce qu’il borne |
|---|---|---|
| Étapes par message | 8 | Le nombre de sollicitations successives du modèle pour un message (1 à 250). |
| Actions par message | 24 | Le nombre d’actions qu’il peut effectuer pour un message (1 à 200). |
| Minutes par message | 5 | La durée pendant laquelle un message peut le faire travailler (1 à 120). |
| Messages par heure | 30 | Les messages par personne et par heure, formulaires rédigés avec l’assistant compris (1 à 1000). |
| Fichiers par discussion | 10 | Les fichiers joints à une conversation (1 à 100). |
| Taille maximale par fichier (Mo) | 25 | Le plus gros fichier téléversé depuis un ordinateur (1 à 500). |
| Taille maximale par image (Mo) | 2 | La taille vers laquelle une image est réduite plutôt que refusée (1 à 20). |
| Images conservées dans le contexte | 4 | Le nombre d’images les plus récentes renvoyées à chaque étape ; 0 n’en envoie aucune (0 à 20). |
Quand un budget s’épuise, chacun lit Limite du mode autonome atteinte : 8 étapes par message. Un administrateur peut la modifier dans Administration › Assistant. et peut cliquer sur Continuer, ce qui ouvre un nouveau budget. Au-delà du nombre horaire, les nouveaux messages de la personne sont refusés pendant un moment : le décompte porte sur la dernière heure.
Recherche web
L’assistant peut chercher sur le web de deux façons.
- Par SearXNG, pour tous les modèles : dans le panneau Recherche web de la page Assistant, cochez Activée, saisissez l’Adresse de SearXNG d’un serveur dont le fichier
settings.ymllistejsondanssearch.formats, puis cliquez sur Enregistrer. L’assistant cherche alors et lit les pages publiques ; les adresses privées et du réseau local restent bloquées. Laissée vide, l’adresse suit celle de l’instance, si son exploitant en a défini une. Avec Activée seul, l’assistant peut lire des pages mais pas chercher. - Chez le fournisseur, pour les modèles Claude : cochez Laisser le fournisseur chercher sur le web sur la carte du modèle. Aucun SearXNG n’est nécessaire ; chaque recherche est facturée par Anthropic en plus des tokens, et ce modèle ne se voit plus proposer la recherche SearXNG, pour ne jamais avoir deux façons de faire la même chose.
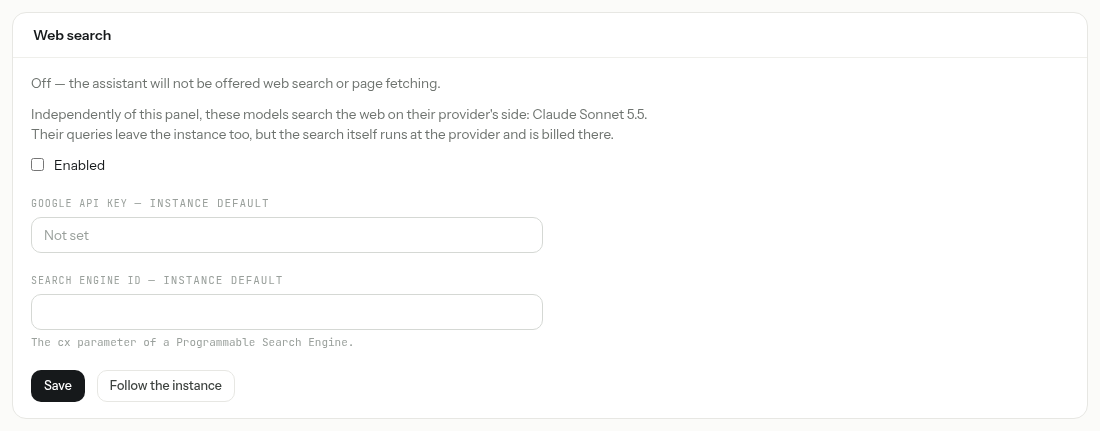
Les termes de recherche quittent PAFworks. Avec l’une ou l’autre recherche, ce que cherche l’assistant est envoyé sous forme de requête au serveur SearXNG, qui la transmet aux moteurs qu’il interroge, ou au fournisseur du modèle. L’assistant a pour consigne de ne jamais mettre le contenu de fichiers, d’e-mails ou de contacts dans une requête.
Ouvrir une page web à côté d’une conversation, avec la validation de la personne, ne demande rien de tout cela : cela se passe dans son propre navigateur. Voir Les pages web et l’extension.
Les programmes dans un bac à sable
Cochez Autoriser l'exécution de code sur la page Assistant pour laisser l’assistant exécuter de courts programmes — calculs, conversions, graphiques. Les programmes s’exécutent dans un bac à sable jetable, avec des limites strictes de mémoire, de processeur et de durée, et ne reçoivent que les fichiers qu’on leur a remis : l’assistant ne voit jamais votre stockage lui-même.
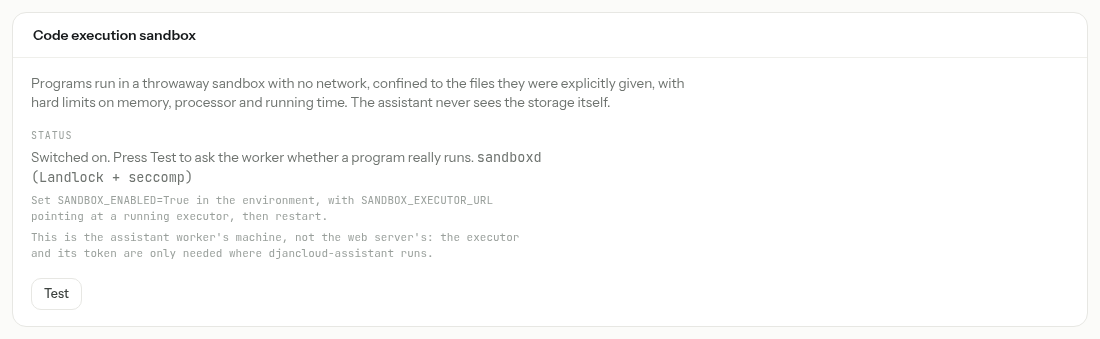
Le bac à sable est installé par votre hébergeur : le panneau Bac à sable d'exécution affiche son état, et Tester exécute un vrai programme et indique Un programme s'est exécuté. ou Aucun programme n'a pu s'exécuter. Quand l’hébergeur a donné un accès réseau aux programmes, le panneau avertit qu’un programme peut alors envoyer ailleurs ce qu’on lui a remis.
Recherche par le sens
La recherche par le sens trouve le passage qui répond à une question même s’il n’a aucun mot en commun avec elle — « le contrat avec le préavis de deux ans ». Il lui faut un modèle qui transforme le texte en vecteurs (un modèle d’embedding), ce qu’Anthropic ne propose pas.
-
Sur la page Modèles de langage, dans Recherche sémantique, cochez Activée et choisissez le Fournisseur : Identique au modèle de langage, Infomaniak, OpenAI, Ollama ou un fournisseur personnalisé.
-
Renseignez l’Adresse du service et la Clé d'API si elles diffèrent de celles du modèle de langage, ainsi que le Modèle : il n’y a pas de valeur par défaut. Cliquez sur Enregistrer.
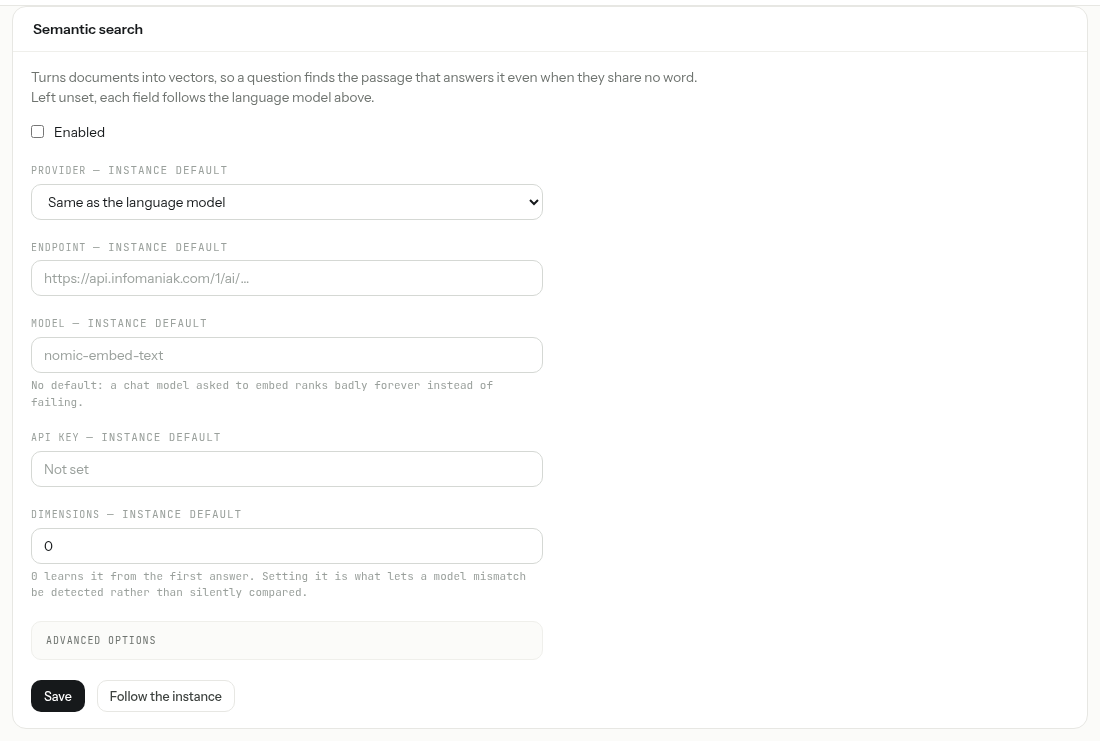
Les documents sont ensuite indexés en arrière-plan, et l’assistant dispose d’une recherche par le sens, à côté de celle par les mots. Suivre l'instance abandonne vos valeurs et revient aux réglages de votre hébergeur.
Les connecteurs d’API : vos propres applications
Un connecteur permet à l’assistant d’appeler une application extérieure — votre ERP, votre CRM, un outil interne — pour les personnes que vous choisissez. Les identifiants restent sur le serveur : l’assistant nomme le connecteur et un chemin, le serveur ajoute la clé, le mot de passe ou la session à l’envoi et les retire de la réponse. L’assistant ne les voit jamais et ne les demande jamais à personne.
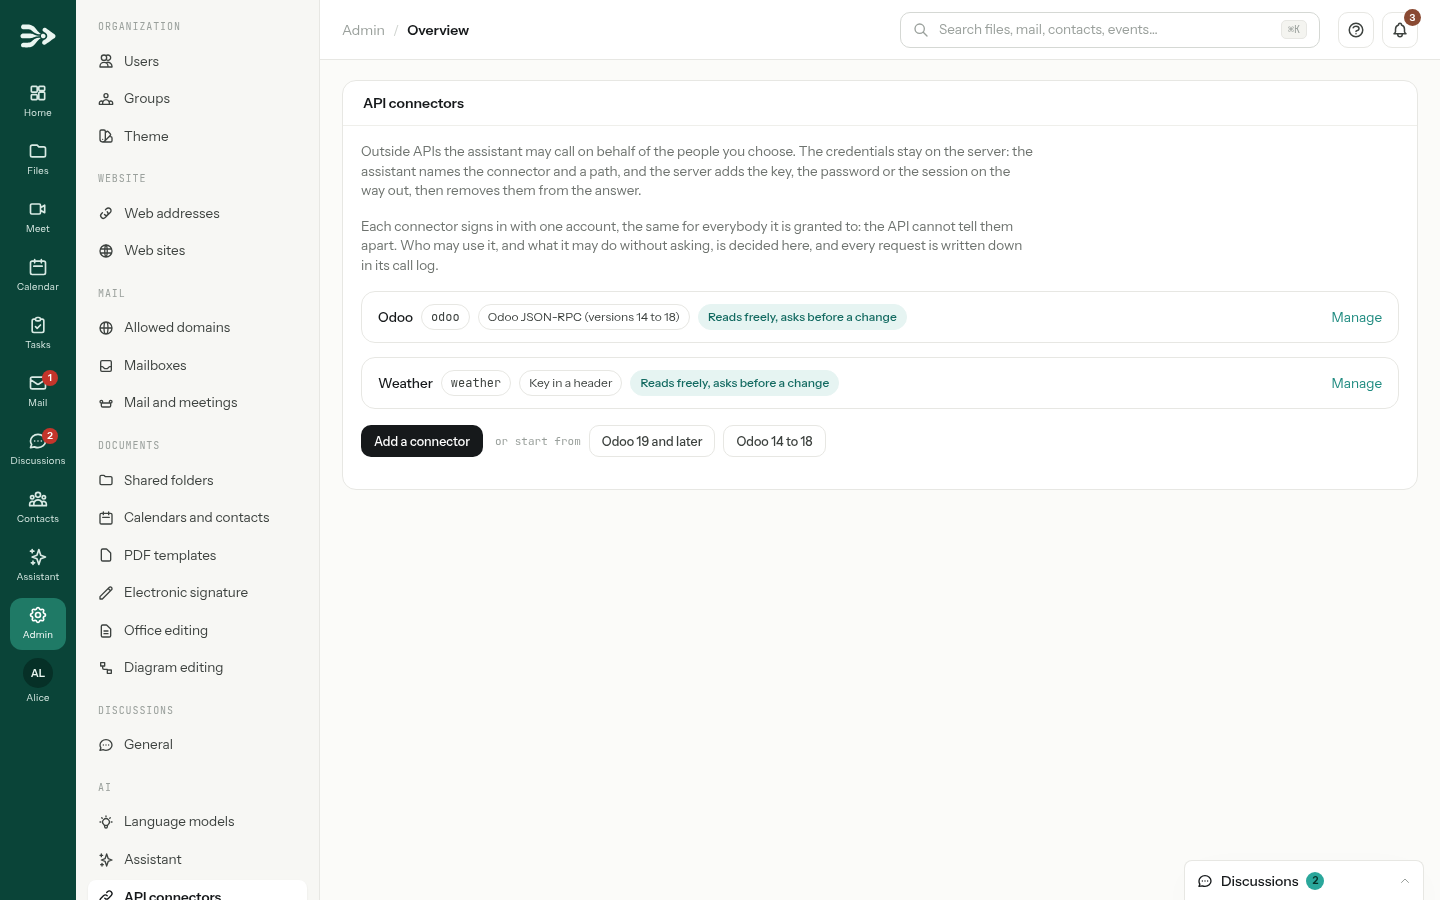
Connecter Odoo
-
À côté de Ajouter un connecteur, cliquez sur Odoo 19 et plus ou Odoo 14 à 18, selon votre Odoo.
-
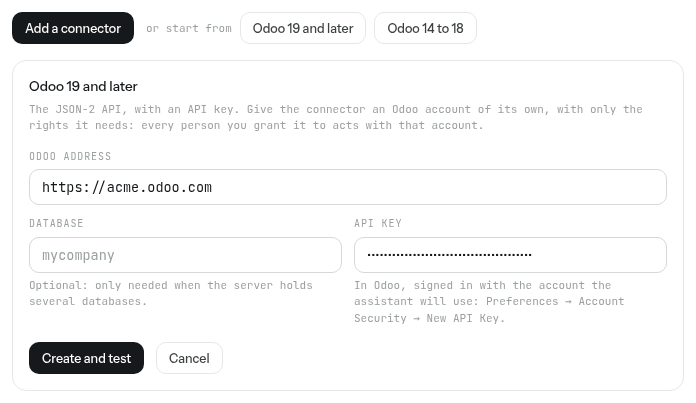
Saisissez l’Adresse d'Odoo et collez la Clé d'API — dans Odoo, connecté avec le compte que l’assistant utilisera : Preferences → Account Security → New API Key. Odoo 14 à 18 demande aussi la Base de données et l’Identifiant du compte Odoo ; Odoo 19 n’a besoin de la base de données que si le serveur en héberge plusieurs. Cliquez sur Créer et tester.
-
Le connecteur s’ouvre, déjà testé. Sous Qui peut l'utiliser, cochez Tout le monde ou ajoutez des personnes et des groupes, puis cliquez sur Enregistrer. Tant que vous ne désignez personne, personne ne peut l’utiliser.
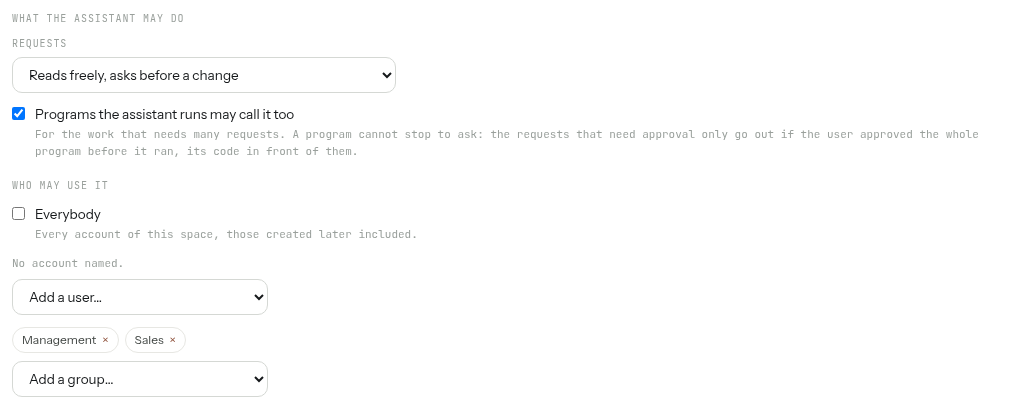
Donnez au connecteur un compte Odoo à lui, avec seulement les droits nécessaires : chaque personne à qui vous l’accordez agit avec ce compte, et Odoo ne peut pas les distinguer. Un connecteur créé avec les boutons Odoo liste les adresses qu’il peut utiliser : la lecture d’enregistrements part aussitôt, la création ou la modification d’un enregistrement attend la validation de la personne, et la suppression d’enregistrements ou la confirmation de documents est refusée.
Ce que l’assistant peut faire
| Requêtes | Ce qui se passe |
|---|---|
| Lecture libre, confirmation avant une modification | Les requêtes de lecture partent ; tout ce qui modifie quelque chose attend la validation de la personne. |
| Seulement les adresses listées | Chaque ligne de Adresses autorisées indique quelles méthodes et quels chemins sont permis (Autoriser) ou soumis à validation (Demander). Ce qu’aucune ligne ne couvre est refusé. |
| Demander à chaque fois | Chaque requête attend la validation de la personne. |
| Tout, sans demander | Chaque requête part. Réservez ce choix à une application en lecture seule, ou dont les modifications sont faciles à annuler : un document écrit pour tromper l’assistant pourrait l’amener à y écrire. |
Une requête en attente montre à la personne ce qui sera envoyé — la méthode, l’adresse et les données — avec Envoyer la requête et Non, merci :
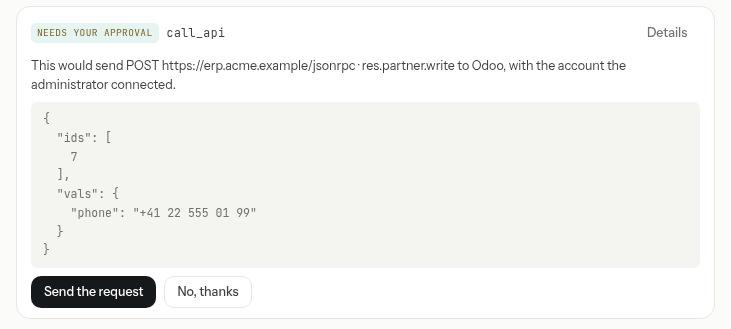
- Les programmes que l'assistant exécute peuvent aussi l'appeler permet à un programme de faire de nombreuses requêtes d’un coup. Un programme ne peut pas s’arrêter pour demander : les requêtes soumises à validation ne partent que si la personne a validé tout le programme, son code sous les yeux.
- Ajouter un connecteur construit à la main tout autre connecteur : son adresse (HTTPS public uniquement), l’authentification — une clé dans un en-tête ou dans l’adresse, un nom d’utilisateur et un mot de passe, une requête de connexion, des identifiants client OAuth2 —, une requête de test, et À quoi il sert, la ligne que l’assistant lit dans chaque conversation pour savoir quand cette application est la réponse.
- Appels récents, en bas d’un connecteur, liste chaque requête : quand, qui, si elle vient de l’Assistant, d’un Programme lancé par l'assistant ou d’un Test de connexion, la requête, le résultat et sa durée.
- Décochez Actif pour ne proposer un connecteur à personne sans perdre ses réglages. Retirer le supprime avec son journal d’appels.
Templates et skills pour tous
Les templates de prompt et les skills sont privés pour la personne qui les écrit. En tant qu’administrateur, vous pouvez partager les vôtres avec toute l’organisation : dans l’assistant, sous Paramètres, ouvrez Skills ou Templates de prompt, choisissez l’entrée, cochez Partager avec toute l'organisation et cliquez sur Enregistrer.
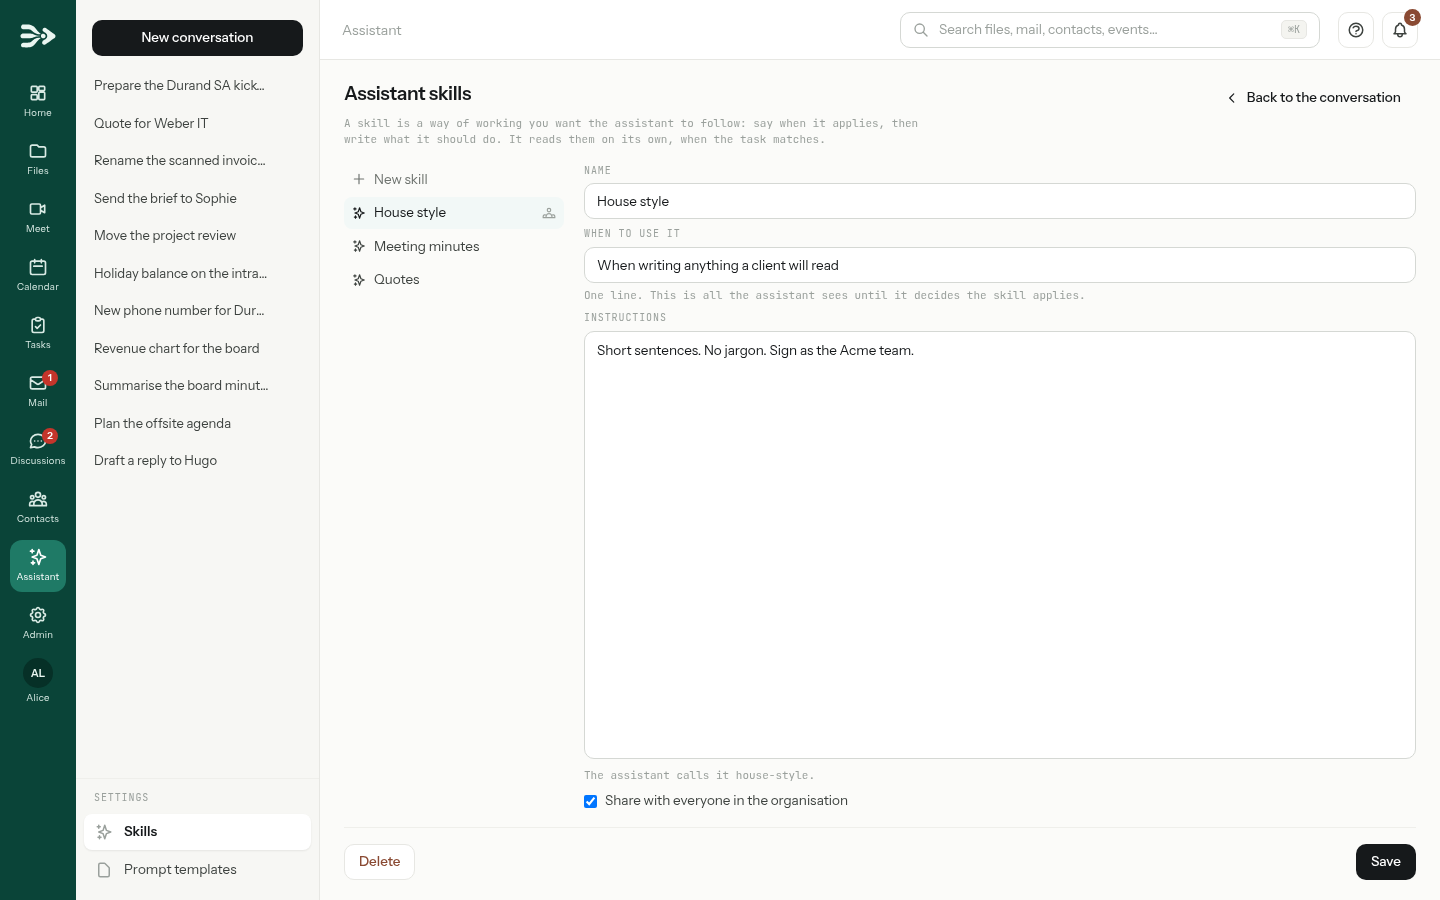
- Une entrée partagée affiche une icône de personnes dans la liste de chacun. Chacun peut l’utiliser, mais pas la modifier.
- Les administrateurs peuvent corriger ou supprimer toute entrée partagée, y compris celle d’un auteur parti. Ils ne voient les entrées privées de personne.
- Un skill partagé est proposé à l’assistant dans les conversations de tout le monde. Une charte rédactionnelle dont le champ Quand l’utiliser dit « Quand vous écrivez quelque chose qu’un client lira » est suivie dans chacun de ces textes, quel que soit le demandeur.
Comment les utiliser : voir Templates de prompt et Skills.
Où vont les données
| Quoi | Destination | Quand |
|---|---|---|
| Les messages, le texte des fichiers joints, tout ce que l’assistant lit avec ses outils (fichiers, e-mails, événements, contacts) et les réponses des applications connectées | Le fournisseur du modèle qui répond à la conversation | Toujours. Un modèle sur votre propre serveur Ollama le garde sur place. |
| Les images jointes, sous forme d’images | Le fournisseur du modèle | Seulement pour un modèle marqué Ce modèle sait lire les images. |
| Les requêtes de recherche | Le serveur SearXNG et ses moteurs, ou le fournisseur du modèle | Quand la recherche web est activée, ou que Laisser le fournisseur chercher sur le web est coché. |
| Des passages de fichiers, d’e-mails et de pièces jointes | Le fournisseur d’embedding | Quand Recherche sémantique est activée. |
| Les requêtes et les données qu’elles portent | L’application du connecteur | Quand quelqu’un utilise un connecteur. |
| Les fichiers remis à un programme | Le bac à sable de votre hébergeur | Quand l’exécution de code est autorisée. Ils n’en sortent que si les programmes ont accès au réseau. |
| Le texte d’une page web ouverte à côté d’une conversation | PAFworks, puis le fournisseur du modèle | Quand la personne la lit par l’extension de navigateur. |
Bon à savoir
- L’assistant agit avec les droits de la personne qui l’utilise : il accède à ce que son compte atteint, et à rien d’autre.
- Il ne peut pas envoyer d’e-mail. Les liens publics, les suppressions de contacts, d’événements et de tâches, les modifications d’événements qui préviennent les participants par e-mail et les requêtes soumises à validation attendent l’accord de la personne.
- Chaque modification qu’il apporte est enregistrée avec la conversation et peut être annulée par la personne. Le journal d’activité note aussi L'assistant a fait des modifications pour chaque réponse qui a modifié quelque chose, et Modification de l'assistant annulée pour chaque annulation.
- Le journal d’appels d’un connecteur garde 90 jours de requêtes par défaut.
- Un modèle Ollama ne reçoit jamais d’images, même avec Ce modèle sait lire les images coché.
- Les conversations restées intactes pendant 90 jours sont supprimées automatiquement ; la durée est fixée par votre hébergeur.
- Les fichiers que chacun téléverse dans une conversation comptent dans son propre quota.
- Décocher Activer les modèles de langage arrête aussi le rangement automatique.